
Your Retry Policy Might Be Multiplying an Outage
Retries improve resilience when failures are temporary.
They can also increase load exactly when a dependency is already struggling.
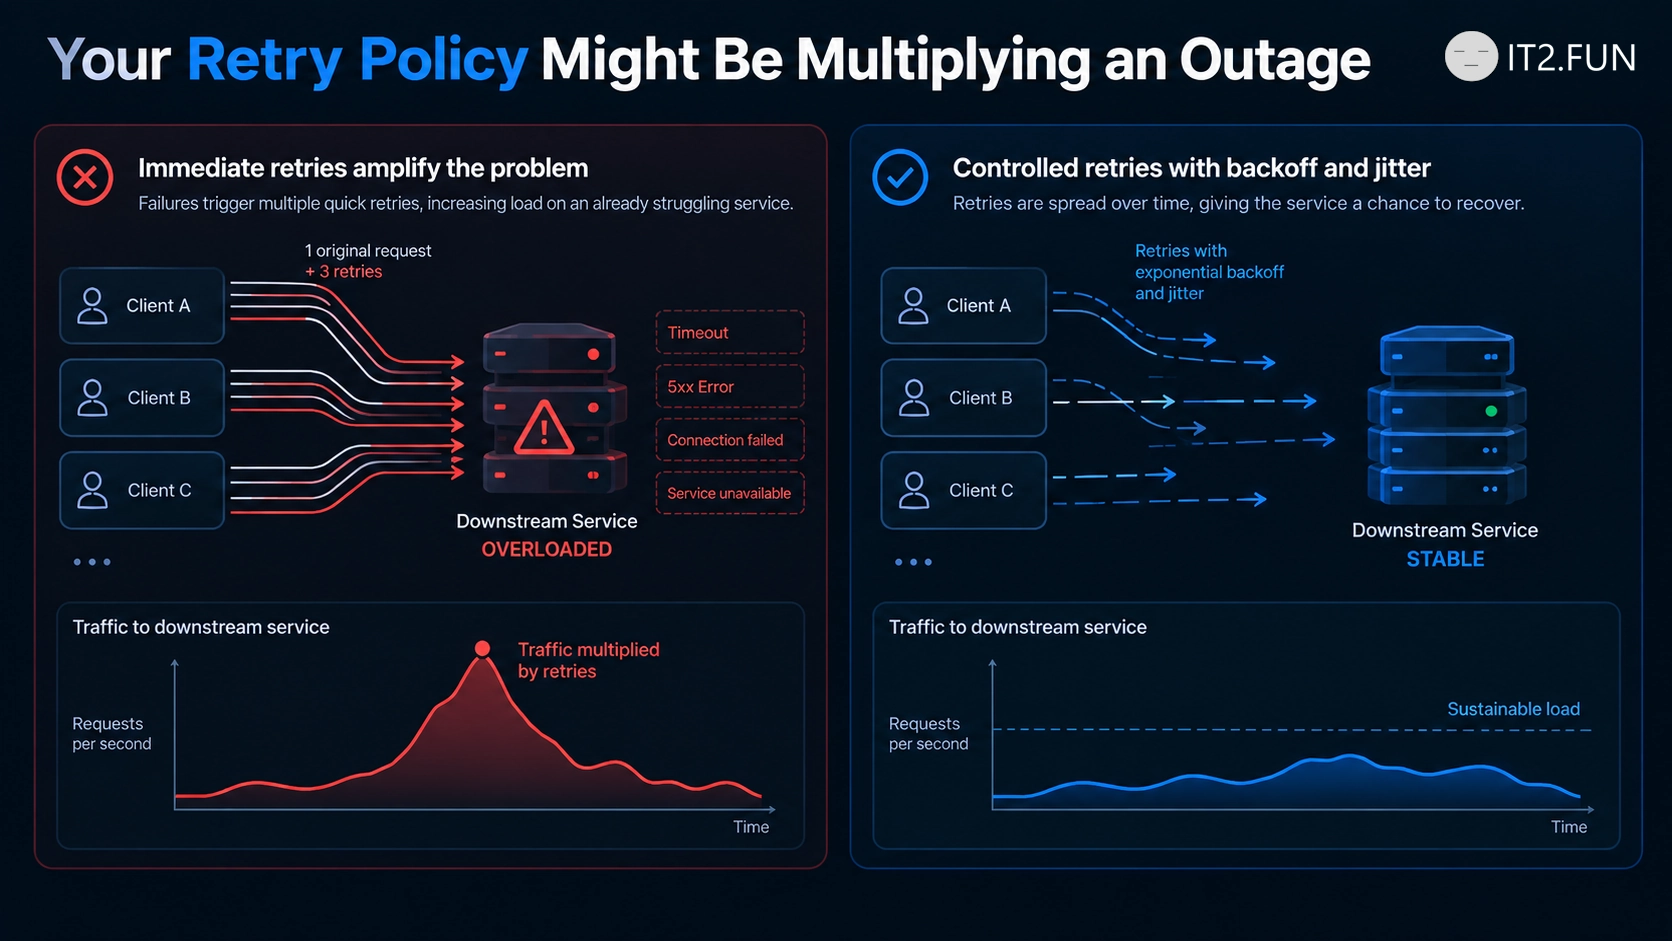
Imagine a service receiving:
1,000 requests/secThe dependency starts failing.
Your policy retries every request three times.
Now the dependency might see something closer to:
Original traffic:  1,000
Retry #1:          1,000
Retry #2:          1,000
Retry #3:          1,000
                    -----
Potential traffic: 4,000 requests/sec
And that's before considering retries at multiple layers.
Service A retries Service B.
Service B retries Service C.
The client retries Service A.
A reliability mechanism can become a traffic multiplier.
Good retry policies usually consider:
- Whether the failure is transient
- Exponential backoff
- Jitter
- Maximum attempts
- Retry budgets
- Request deadlines
Retry-Afterguidance- Whether another layer is already retrying
Retries don't create capacity.
If a dependency is overloaded, sending it more requests immediately might not be the recovery strategy you want.
Retry when another attempt has a reasonable chance of succeeding.
Then give the dependency some time before asking again.